AI 伺服器的重點,不只在運算能力,也在於能否銜接企業的工作流程。開箱即用 AI 伺服器應依訓練與推論需求規劃運算資源、擴充方式及地端部署架構,並一併考量資料安全與日常維運。配置合適,才能減少設備到位後仍需反覆整合的落差。
評估導入時,企業需要釐清訓練與推論的資源差異、後續擴充方向,以及地端運作如何納入安全管理。本文將說明伺服器配置、軟硬體整合與部署服務的考量重點,並整理開箱即用方案如何銜接企業既有環境,協助您依實際工作負載規劃導入,讓技術配置與營運需求彼此配合。
关键要点
- 訓練與推論的工作負載不同,伺服器配置應從實際應用需求出發。
- 開箱即用服務的價值,在於整合硬體、軟體與企業流程,降低部署銜接的複雜度。
- 規劃硬體時同步考量擴充方向,有助於讓運算資源隨應用需求逐步調整。
- 地端部署除了資料管理,也需要將執行環境與存取控制納入安全規劃。
- 釐清工作負載、既有環境與治理需求,能讓導入方案更貼近企業的營運情境。
目录
AI 訓練與推論伺服器
企業規劃人工智慧伺服器,首先要分清訓練與推論。訓練是利用資料建立或調整模型。推論則是把已建立的模型用於實際任務。兩者目的不同,運算負載也不同。美國國家標準暨技術研究院指出,高效能運算系統可用於訓練人工智慧與機器學習模型,並以極高速度執行。這項能力能支援模型運算,但不能取代工作負載分析。伺服器配置仍須回到企業要執行的任務。
以內部知識問答為例,團隊可能先整理文件,再建立可供模型使用的資料流程。訓練工作著重模型與資料的處理,執行時間和資源需求會受到資料量、模型選擇及訓練方式影響。若企業只需要使用已準備好的模型,主要工作就轉為推論服務。此時應了解同時使用者、請求類型與回應流程。兩類工作若共用運算資源,負載高峰便可能互相影響。因此,設計前要先列出各項任務與使用情境。
訓練伺服器的評估,不能只看單一硬體項目。專業規劃會先釐清資料如何進入系統,再確認模型運算、儲存與資料傳輸如何銜接。資料讀取若跟不上運算,整體流程仍可能受阻。模型訓練完成後,也要安排模型檔案的保存與後續使用。企業若會反覆調整模型,就需要把訓練流程和模型管理一併納入架構。這樣才能掌握從資料準備到模型部署的實際路徑,而非只配置一台伺服器。
推論伺服器則要從服務方式切入。若模型用於文件分類,請求可能以批次方式進入;若用於內部問答,使用者則會逐次提出問題。兩種情境的使用節奏不同,系統規劃也應反映差異。部署人員會檢視模型如何接收輸入、如何回傳結果,以及哪些企業系統需要串接。接著評估多個應用是否共用同一套推論服務。服務範圍、工作流程與存取方式,都會影響資源安排。
開箱即用 AI 伺服器的價值,在於降低硬體與應用環境之間的整合落差。它不代表所有模型與工作負載都適用同一配置。導入前,專業團隊會整理訓練與推論的優先順序,確認預計採用的模型及資料流程,再規劃相應的運算環境。若企業同時有模型訓練和日常推論需求,架構還要安排兩者的資源使用方式。重點不是把兩類工作硬塞進同一流程,而是讓它們能依營運需求穩定銜接。
評估服務品質時,可沿著部署流程觀察工作是否完整。第一步是盤點任務與資料來源。第二步是分析模型運作方式和應用端需求。第三步是規劃伺服器環境、資料路徑及系統串接。最後,透過實際情境測試訓練或推論流程,確認輸入、運算與結果回傳能否配合工作需要。這些步驟能讓配置決策有依據,也便於後續擴充時辨識需要調整的環節。
企業內部還要明確區分模型研發與應用服務的責任。資料團隊可能負責整理內容,應用團隊則需要將推論結果接回既有流程。若雙方使用的資料格式、模型版本或權限安排不一致,交接便會增加管理成本。因此,伺服器規劃應同步整理模型如何更新、應用如何呼叫,以及運作問題由哪個流程處理。這些安排不是硬體規格,卻會直接影響系統能否持續投入實際工作。
訓練與推論的配置也需要留意變化。企業可能先從單一知識問答或文件處理場景開始,之後再加入其他部門的應用。規劃時,專業人員會辨識哪些資源可沿用、哪些流程必須調整,並將擴充需求納入架構討論。若需求以推論為主,重點在於服務流程與應用串接;若需持續訓練模型,則需把資料處理及訓練作業納入整體設計。先釐清工作負載,才能讓伺服器真正配合企業的使用方式。
企業級開箱即用 AI 服務
企業需要的不是單獨一台設備,而是能接入實際流程的應用環境。完整服務通常從需求盤點開始,再把硬體、模型執行環境、資料來源與應用介面串接起來。以內部知識問答為例,規劃內容可能包括文件來源、搜尋與回覆流程,以及員工如何提出問題。若只完成設備安裝,卻未處理資料與應用之間的銜接,系統便難以融入日常作業。
導入前,專業團隊會先將需求轉成可執行的工作範圍。第一步是辨識使用情境,例如文件查詢、內容分類,或內部流程中的文字處理。第二步是盤點相關資料與既有系統,了解資料如何提供、結果要回到哪個工作環節。第三步則是確認應用的使用者、權限與操作方式。這些資訊能協助界定部署範圍,也能避免把「想使用人工智慧」當成沒有邊界的工程需求。
環境建置時,整合工作不只涉及伺服器。系統還要安排模型執行環境、資料存取路徑,以及應用端的串接方式。例如,文件處理流程可能從檔案匯入開始,再擷取文字、整理內容,最後交由使用者檢視或查詢。每個環節都要釐清資料格式、流程責任與輸出用途。若既有系統需要交換資料,整合規劃也應納入接口與作業順序,讓新應用不致成為孤立工具。
「開箱即用」不等於所有企業採用同一套設定。企業的資料型態、內部流程與使用情境各有差異,部署內容也應隨需求調整。以知識管理為例,若使用者需要查找不同部門的文件,設計時便要考慮資料來源如何分類,以及查詢結果如何呈現。若應用是文件自動化,則要梳理文件進入、處理與後續使用的流程。服務的價值在於將必要環節整合好,而非只縮短設備到場後的設定工作。
驗收階段應以實際任務檢視整體流程。團隊可依事先界定的情境,逐項測試資料是否能進入系統、應用是否能正確呼叫模型,以及結果能否回到預定工作環節。以內部問答為例,測試不應只看畫面能否開啟,也要觀察提問、資料檢索與回覆是否連貫。若流程中有人工覆核,也應納入驗收情境。這類測試能找出串接或操作上的落差,讓調整建立在實際使用方式上。
交付時,清楚的文件與權責安排同樣重要。部署團隊應整理系統組成、資料流向、使用方式及日常管理涉及的流程,讓企業相關人員理解應用如何運作。若後續要增加新的資料來源或工作情境,這些紀錄也能作為調整架構的依據。企業內部則需明確安排應用負責人、資料管理角色與使用者回饋管道,避免問題在部門之間來回傳遞,卻找不到對應的處理流程。
評估服務範圍時,可從需求釐清、環境整合、應用測試與交付管理逐項檢視。若企業已有明確應用情境,專業團隊可據此規劃部署與系統銜接;若需求仍在整理,則可先聚焦於最需要改善的工作流程。這種分階段方式,能讓導入目標與組織準備程度保持一致。當企業正在規劃文件處理或內部知識應用時,可參考企業人工智慧整合規劃,進一步梳理服務與現有流程的銜接方向。
伺服器硬體配置與擴充
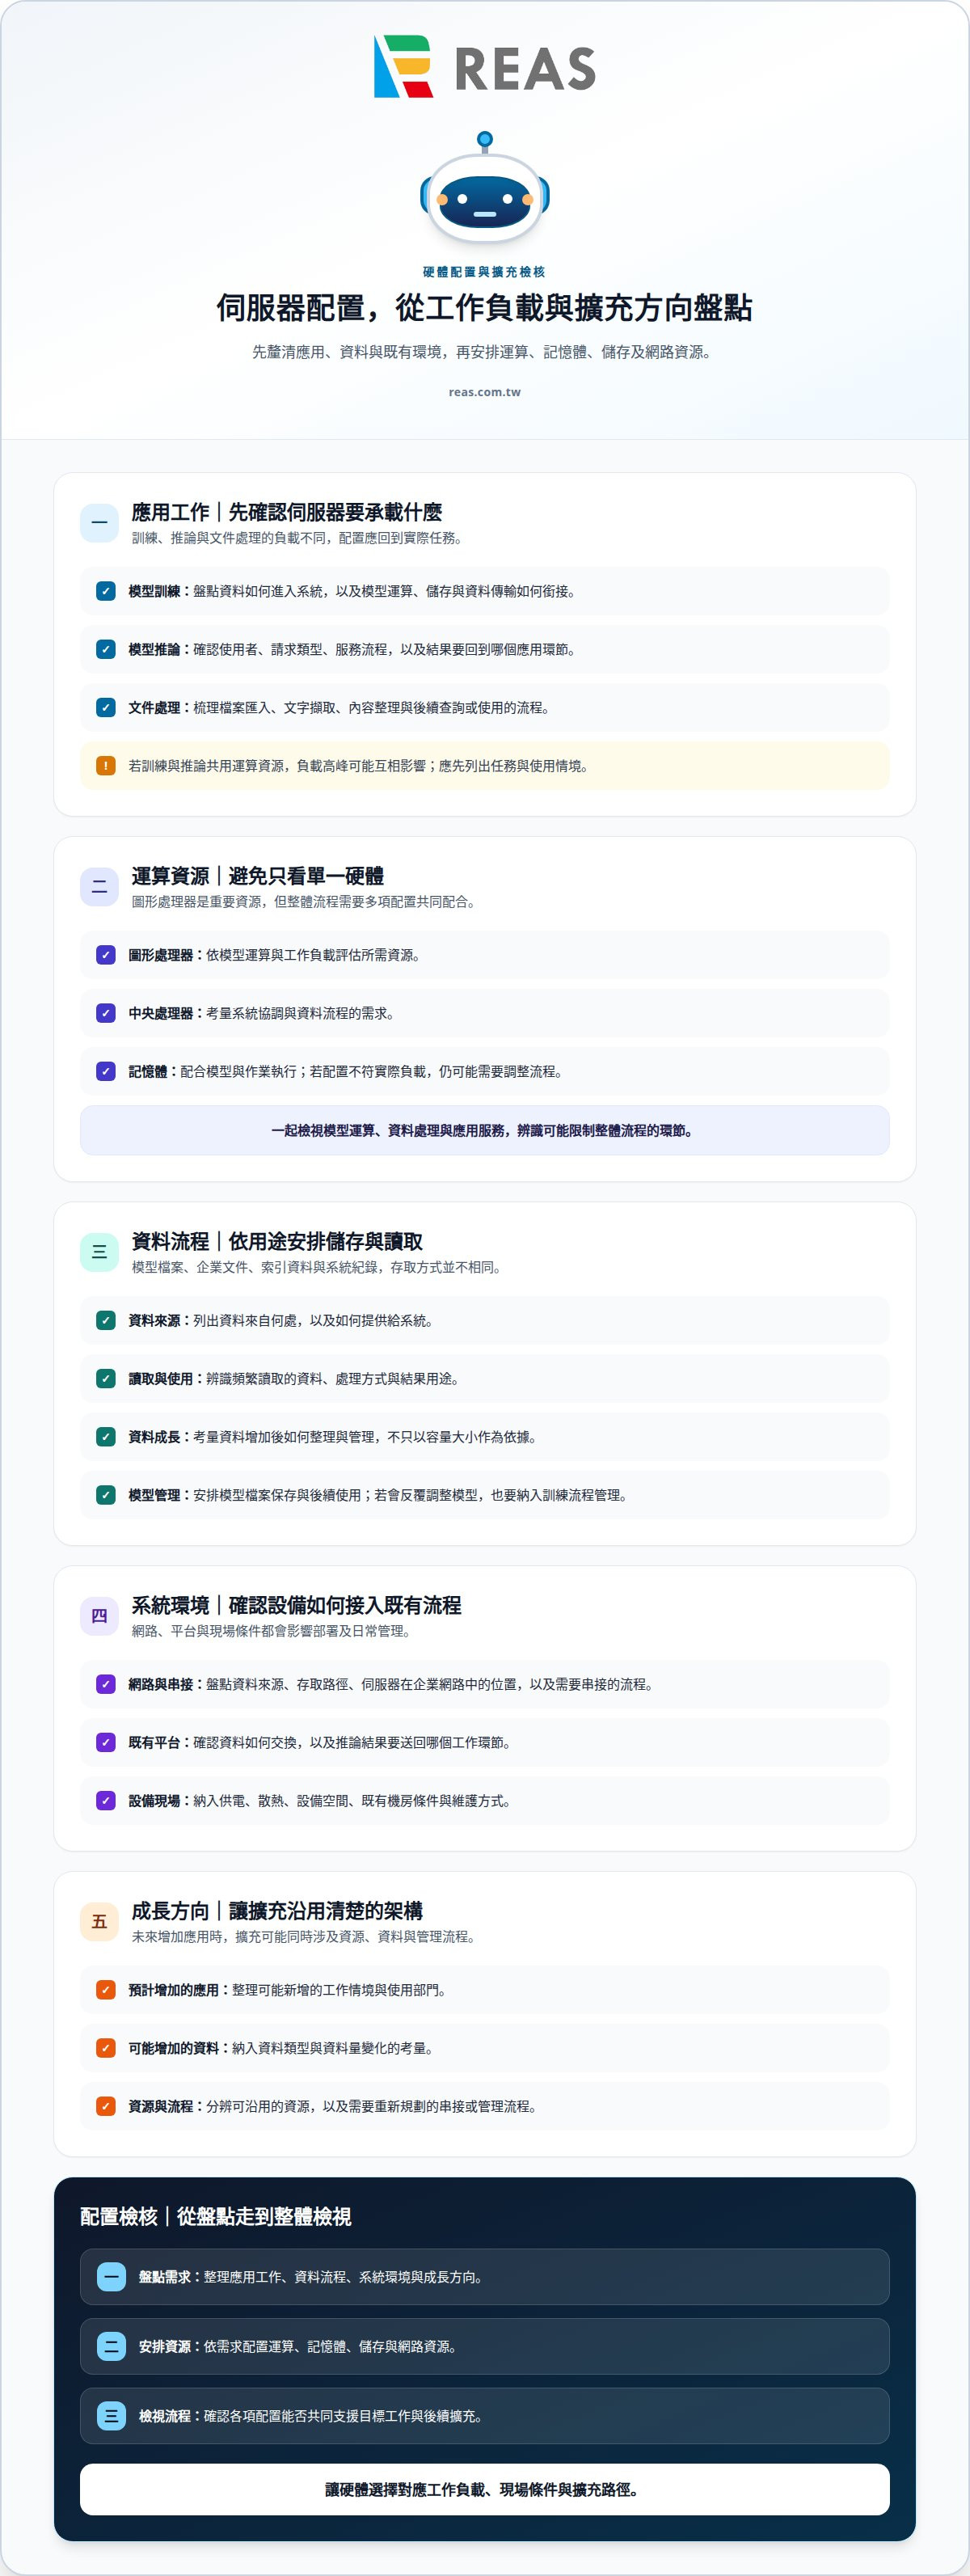
硬體配置應從預計承載的工作開始,而不是先挑選單一零件。以文件檢索為例,伺服器需支援模型運算,也要處理文件讀取、索引與查詢。若工作包含模型訓練,運算需求又會不同。規劃人員會先整理應用情境、資料量變化及使用方式,再評估各項硬體資源。這能避免設備規格看似充足,實際流程卻受其他環節限制。
圖形處理器通常是人工智慧運算的重要資源,但配置時不能只看圖形處理器本身。中央處理器負責協調系統與資料流程,記憶體則支援模型和作業執行。以同時處理文件與模型推論的工作為例,若記憶體配置不符合實際負載,系統仍可能需要調整工作流程。專業評估會將模型運算、資料處理及應用服務一併考量,避免單一零件成為整體瓶頸。
儲存設備也要依資料用途規劃。模型檔案、企業文件、索引資料與系統紀錄,存取方式並不相同。以知識問答服務為例,文件匯入、索引建立與日常查詢可能同時發生。規劃時需辨識哪些資料需要頻繁讀取,哪些資料適合分開管理,並考量資料成長後如何整理。儲存配置應配合資料流程,而不是只以容量大小作為唯一依據。
伺服器與企業既有環境之間,也需要適當的網路連接。若應用要從內部系統取得資料,再將推論結果送回工作流程,網路設計便會影響資料交換與使用方式。部署團隊會盤點資料來源、存取路徑及系統串接需求,並確認伺服器在企業網路中的位置。以文件分類應用為例,檔案可能從內部系統進入處理流程,完成後再交由相應作業使用。
硬體規劃還要納入供電、散熱與設備空間。伺服器持續承載運算工作時,周邊環境必須配合設備運作需求。評估流程會了解設備放置位置、既有機房條件與維護方式,並把這些限制納入部署安排。若忽略現場條件,即使運算資源符合需求,安裝與日常管理仍可能增加難度。因此,硬體盤點應涵蓋設備本身及其運作環境。
擴充規劃則要先辨識未來可能增加的工作。企業可能從單一文件應用開始,後續再加入其他部門的模型服務。此時,擴充不只是增加運算資源,也可能涉及儲存容量、資料串接與使用管理。專業團隊會區分可延續使用的部分,以及需要重新規劃的流程,讓後續調整能沿用既有架構。這比只預留硬體空間,更能反映實際營運變化。
可用以下項目整理配置需求:
- 應用工作:模型訓練、推論,或文件處理等服務。
- 資料流程:資料來源、讀取方式、儲存與結果用途。
- 系統環境:網路位置、既有平台及需要串接的流程。
- 成長方向:預計新增的應用、使用部門與資料類型。
完成盤點後,部署人員可依需求安排運算、記憶體、儲存與網路資源,再檢視各項配置能否共同支援目標流程。若企業後續要增加應用,也可依擴充方向調整架構,而不必把每次新增需求都視為獨立建置。評估伺服器時,最重要的是確認硬體選擇如何對應工作負載、現場條件與擴充路徑,讓設備配置服務於企業流程。
地端部署與資料安全
地端部署讓企業能在內部環境執行人工智慧應用,但資料留在內部,不代表安全工作已經完成。仍須規劃誰能使用系統、模型可讀取哪些資料,以及結果如何流向其他流程。以內部文件問答為例,系統可能同時接觸人事制度、作業手冊與部門文件。若資料權限沒有納入設計,回答就可能跨越原有的存取界線。部署規劃應先描繪資料流向,再逐項界定使用範圍。
美國國家標準暨技術研究院指出,本機人工智慧代理及其推理模型需要在經過強化與安全防護的執行環境中部署。組織也可預先限制代理,並採用類似雲端部署的控制措施。這表示安全設計不只處理伺服器,也要涵蓋模型能執行的操作、可接觸的資料,以及使用者如何提出要求。例如,文件問答代理可被限定為檢索指定資料並回覆,不應被默認授權執行其他系統操作。
資料盤點是建立控制邊界的起點。部署團隊會整理資料來源、使用目的、存取角色與處理流程,再將需求轉成系統設定。以部門知識庫為例,財務文件、採購流程與一般作業手冊可分別界定使用範圍。若所有內容都放進同一個查詢集合,使用者原有的權限差異便可能難以落實。因此,資料分類與權限設計應同步進行,而不是等應用上線後才補做。
接著要檢視輸入與輸出。員工提問可能包含客戶資料、內部紀錄或尚未公開的內容;模型回覆也可能被複製到其他工作平台。設計者應說明哪些資料可以提交、哪些資料可供模型檢索,以及結果如何呈現和保存。以合約查詢為例,系統需要依預定資料範圍處理問題,並讓使用者理解回覆來自哪些內容。清楚的處理路徑,有助於管理資料從輸入到使用的各個環節。
地端環境也要納入身分與權限管理。企業可依職務安排使用者存取範圍,並區分一般使用、系統管理與資料維護等角色。若部門人員轉調或工作內容改變,權限管理流程也應能配合更新。日誌紀錄則可協助管理者了解系統使用情形,例如檢視哪些功能被使用、哪些流程需要排查。這些設計須配合企業既有治理方式,不能只靠伺服器所在位置來判斷安全程度。
模型與資料更新同樣需要治理。若知識文件內容改版,部署流程應能辨識更新來源,並安排資料重新整理與應用檢視。若模型版本調整,則要記錄變更內容及其影響的服務流程。以人事制度查詢為例,舊版文件若仍留在檢索範圍內,使用者可能取得不合時宜的資訊。因此,資料更新、模型變更與使用者回饋都應有對應的管理步驟,讓維護工作可追溯。
地端部署還需考量故障處理與資料復原。規劃人員會釐清重要資料保存位置、系統中斷時的處理方式,以及恢復服務所需的作業順序。不同應用的重要程度不同,內部知識查詢與關鍵作業流程的復原安排也可能有別。部署測試可納入權限檢查、資料更新、異常回報及復原流程,確認管理責任與系統操作相互配合。這些準備能讓安全措施落在日常運作,而非停留在架構文件。
企業在設計內部人工智慧環境時,可先整理資料邊界、使用角色、代理可執行的任務與更新流程,再由專業團隊規劃部署控制及整合方式。若需把私有化環境、應用流程與治理需求一併納入設計,可洽談地端人工智慧部署規劃,讓安全控制對應實際工作情境。
REAS 睿思智慧
REAS 睿思智慧協助企業盤點 AI 伺服器需求,並整合硬體環境、企業應用與既有流程進行規劃。若您正在評估地端部署、資料治理或內部系統串接,可透過 AI 系統整合與夥伴共創、AI 顧問落地陪跑,逐步釐清應用範圍與導入方式。Neuro PrivateHub 結合 AI Server 硬體與軟體平台,協助企業管理資料、模型與權限;搭配快速啟用企業 AI 應用方案,讓 AI 更貼近實際營運需求。歡迎聯絡 REAS 睿思智慧,預約 AI 導入諮詢,討論適合企業情境的規劃方向。
從明確需求開始規劃下一步
導入開箱即用 AI 伺服器,可以從一項具體工作需求開始,而不必一次改動整體營運架構。先界定預計改善的流程、資料使用邊界與內部協作方式,再逐步形成符合企業現況的部署藍圖。這讓技術選擇有清楚依據,也讓後續擴展能接續實際經驗。
REAS 睿思智慧提供 Neuro PrivateHub、快速啟用企業 AI 應用方案,以及 AI 系統整合與夥伴共創,協助企業把應用構想連結到部署規劃。若您正整理導入方向,歡迎聯絡 REAS 睿思智慧,討論企業 AI 伺服器規劃,讓下一步從清晰、可執行的需求開始。