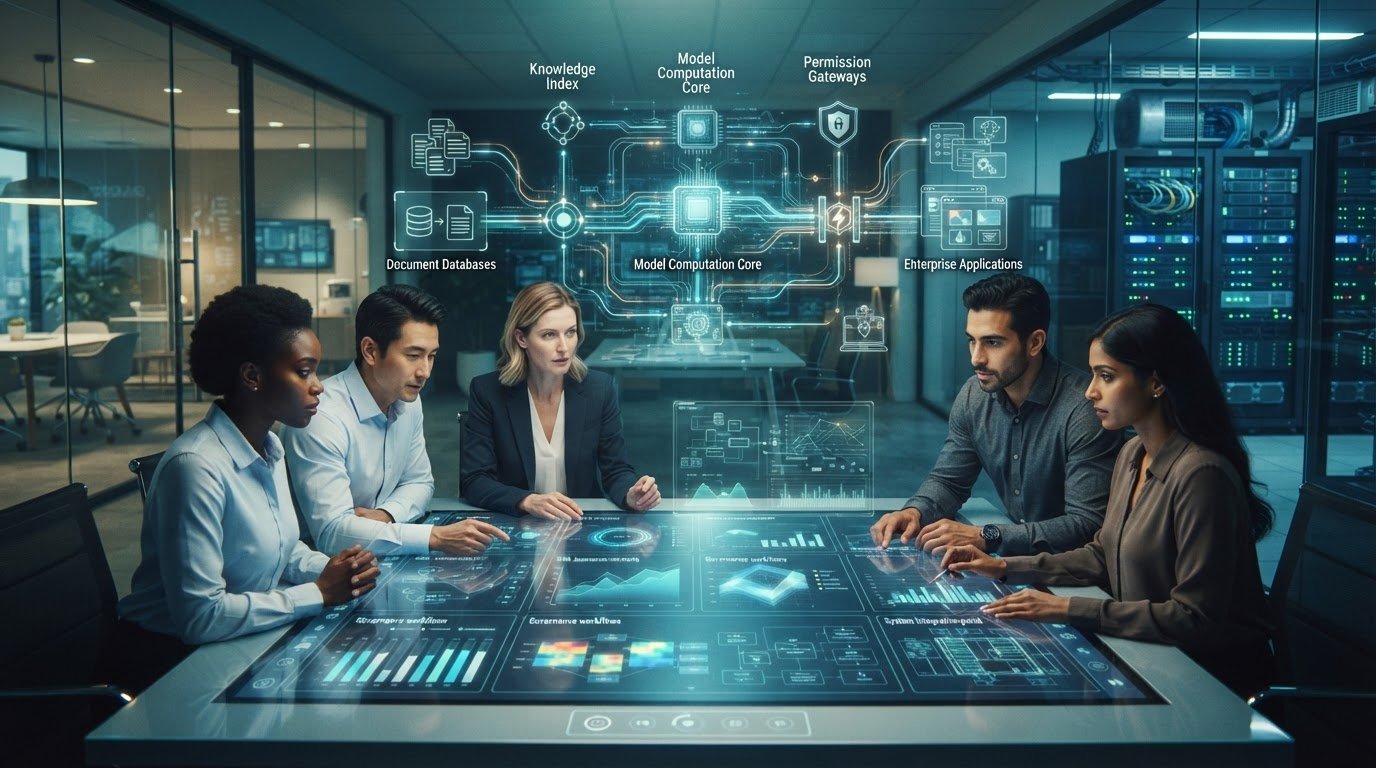
企業私有化 AI 部署,是否只要採購伺服器,就能確保資料受控、應用順利上線?實際上,設備只是起點。資料治理、系統整合與後續維運若未同步規劃,即使完成部署,也可能無法落實到日常工作。
擔心機敏資料如何管理、不確定該先選模型還是平台,或顧慮新系統無法接上既有流程,都是合理的評估起點。私有化部署不是單一技術選擇,而是要依使用情境與組織條件,逐步確認架構和治理方式。
本文將從需求盤點、架構選擇與風險評估,談到整合驗證及上線維運,說明各階段應確認的決策條件,協助你建立可逐步驗證、擴充並納入治理的導入方向。
重點整理
- 先盤點實際工作情境與資料敏感程度,再判斷私有化部署是否合適。
- 了解資料來源、知識檢索、模型服務與應用介面的協作關係,才能掌握整體架構。
- 評估企業私有化 AI 部署方案時,應一併比較資料流向、系統整合、擴充方式與維運責任。
- 透過需求盤點、資料檢視、概念驗證、整合上線與持續維運,逐步確認各階段的成果與決策條件。
- 釐清企業內部、整合夥伴與平台供應方的分工,明確界定資料、模型與維運工作的責任。
目錄
- 企業私有化 AI 部署是什麼?先釐清需求與適用情境
- 企業私有化 AI 部署架構:模型、資料與應用如何協作?
- 如何評估企業私有化 AI 部署方案?比較架構與取捨
- 企業私有化 AI 部署如何分階段落地與驗證?
- 從部署規劃到持續維運:建立可控的企業 AI 路徑
企業私有化 AI 部署是什麼?先釐清需求與適用情境
企業私有化 AI 部署,是在企業可管理的環境中建置並運用 AI,同時規劃資料如何進入、使用、保存及管理。部署位置可能是企業自有設備或其他受控環境。重點不只在模型放在哪裡,也包括誰能使用、哪些資料能被讀取,以及系統如何接入日常流程。這與購買單一模型、透過應用程式介面租用模型服務,或使用一般雲端應用不同。後幾者著重取得特定服務;私有化則需要一併考量資料流、平台、整合及維運責任。關於地端軟體的基本概念,可參考 On-premises software。
哪些企業需求適合評估私有化 AI 部署?
與其先問要買哪種模型,不如先確認工作情境。若員工需要檢索內部知識、整理文件,或在既有流程中使用 AI 協助,而且相關資料與存取方式需要由企業自行管理,就值得進一步評估。相對地,若只是想試用新工具,卻尚未界定使用者、資料來源與預期結果,直接投入完整部署可能為時過早。
盤點時可先回答幾個問題:誰會使用?資料存放在哪裡、由誰維護?AI 的回答會影響哪項工作或決策?出現錯誤時由誰覆核與處理?這些答案能協助企業判斷所需的控管、整合與驗證方式,避免只依模型功能做選擇。
私有化部署不代表什麼?
把系統部署在地端或受控環境,不會自動改善資料品質,也不會讓模型不再出錯。私有化不等於企業必須自行訓練大型模型,也不代表完全不需要外部技術或整合協作。安全成效仍取決於架構設計、權限設定、系統維護及組織治理,部署地點只是其中一項條件。
因此,除了確認資料是否留在預期環境,也要訂出使用者權限、操作紀錄、資料保存與刪除方式,以及各單位的處理責任。若導入 Neuro PrivateHub 等企業私有化平台,也應依實際情境檢視平台如何配合既有系統與管理流程。環境受控,不等於治理已完成;先釐清需求與責任,才能把控管落實到日常營運。
企業私有化 AI 部署架構:模型、資料與應用如何協作?
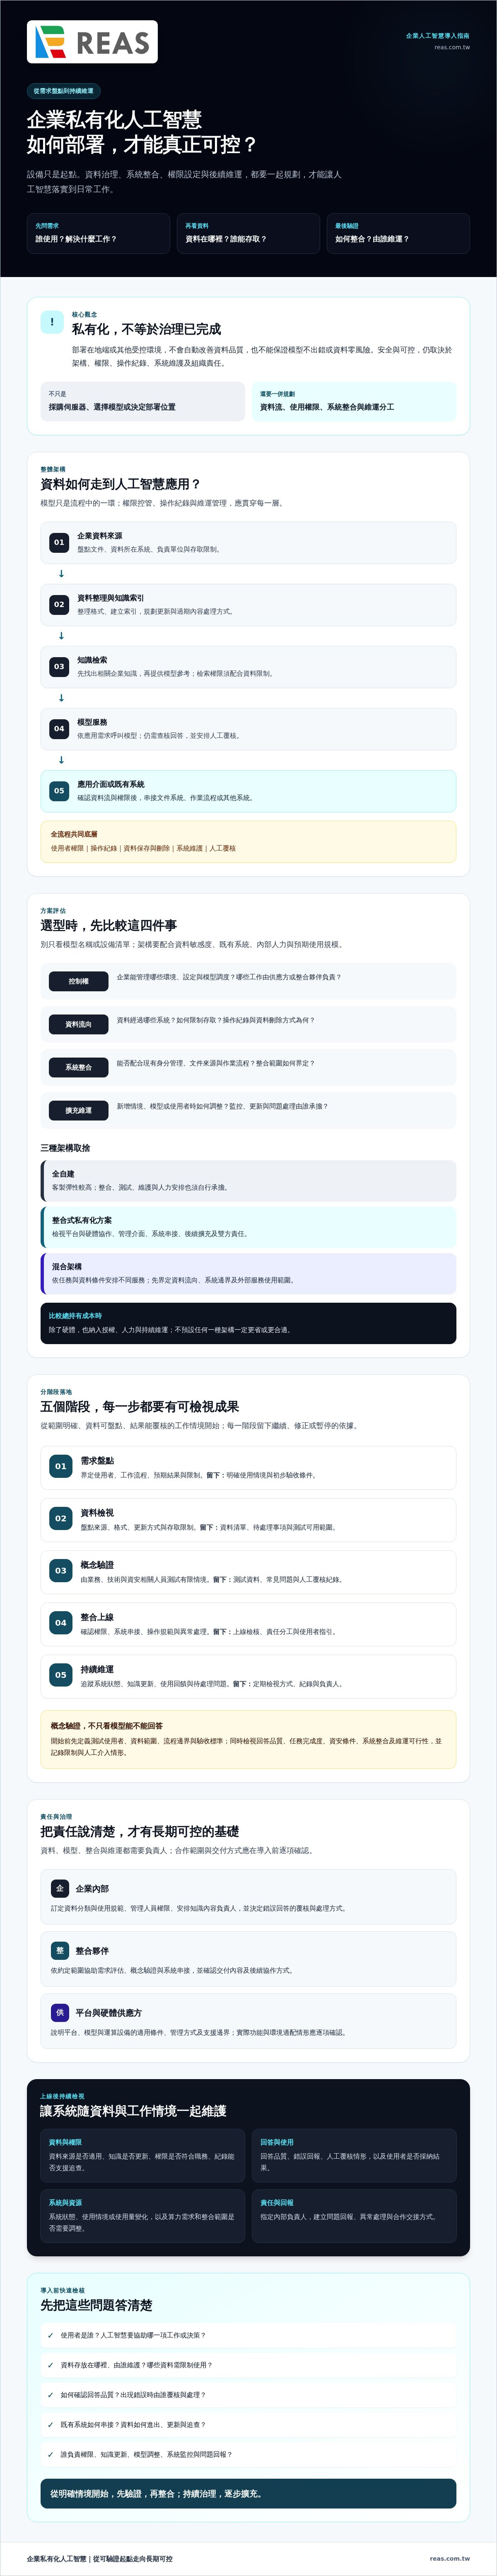
企業私有化 AI 部署不是把模型放進內部環境就算完成,而是要讓資料、檢索、模型、應用與管理機制形成可控流程。可先用這條路徑理解整體架構:
企業資料來源 → 資料整理與知識索引 → 知識檢索 → 模型服務 → 應用介面或既有系統
權限控管、操作紀錄與維運管理貫穿各層
大型語言模型會依收到的指令與內容生成回答;檢索增強生成(RAG)則可先從企業知識中找出相關資料,再提供模型參考。這有助於讓回答結合內部資訊,但不代表資料一定完整,也無法消除模型產生錯誤內容的可能,仍須安排查核與人工覆核。
企業資料如何進入 AI 知識流程?
資料進入知識流程前,先盤點來源與負責單位,再整理文件格式、建立索引,並規劃內容更新及過期資料的處理方式。若原始資料有不同存取限制,索引與檢索也應納入相應權限,避免使用者查到不應檢視的內容。敏感資料如何分類與處理,應由企業資安團隊依內部政策確認。保留資料來源與更新紀錄,有助於檢查回答依據,並在知識變動時維護索引。
模型與既有系統如何安全協作?
模型調度負責依應用需求呼叫適合的模型服務;應用介面與應用程式介面(API)則可在確認權限與資料流後,連接文件系統或其他既有系統。單一模型無法取代這些整合與管理工作。例如,可將角色型存取控制(RBAC)作為權限設計概念,依角色限制可查詢或執行的功能,並透過操作紀錄與人工覆核支援後續檢視。實際配置仍須配合企業架構確認。
運算設備也要依模型選擇、預期使用量與部署需求評估。AI Server 可提供模型服務所需的運算環境,但設備規格不宜脫離整體架構單獨決定。企業可參考 NIST AI 風險管理框架了解風險管理思路,再由內部團隊確認適用的控管做法。若正整理平台、資料與系統的協作需求,可進一步了解企業私有化 AI 平台架構。
如何評估企業私有化 AI 部署方案?比較架構與取捨
選擇方案時,別只比較模型名稱或設備清單。企業私有化 AI 部署的關鍵,是架構能否配合資料敏感度、既有系統、內部人力與預期使用規模。可先用以下維度整理需求,再請相關團隊逐項確認:
- 部署控制權:確認企業能管理哪些環境、設定與模型調度,也要釐清哪些工作須由供應方或整合夥伴負責。
- 資料流向:盤點資料會在哪些系統間傳遞、如何控管存取,以及紀錄與刪除方式。
- 系統整合:確認方案能否配合現有身分管理、文件來源與作業流程,並界定整合範圍。
- 擴充與維運:評估新增使用情境、模型或使用者時如何調整,以及日常監控、更新與問題處理由誰承擔。
自建、整合式方案與混合架構怎麼比較?
三種方式沒有固定的優劣,差別在於控制彈性與承擔責任的比例:
- 全自建:企業可依自身需求規劃各層組件,客製彈性較高;相對地,整合、測試、維護與人力安排也需自行承擔。
- 整合式私有化方案:評估平台與硬體的協作方式、管理介面、既有系統串接範圍,以及日後擴充或調整的條件。應確認供應方與企業各自負責哪些工作,而非只看初始建置。
- 混合架構:可依任務與資料條件安排不同服務,但須先界定資料流向、系統邊界,以及哪些資料和工作允許使用外部服務。
若資料高度敏感且內部具備維運能力,企業可能更重視環境控制與自主調整;若整合人力有限,則應仔細檢視整合式方案的責任分工。使用規模與既有環境也會影響選擇。比較總持有成本時,別只看設備,也要納入硬體、授權、人力與持續維運等項目,不預設某種架構一定更省或更合適。
選型時哪些問題比模型名稱更重要?
先確認資料能否留在指定環境,並釐清存取、操作紀錄與刪除方式;再以實際任務檢視模型的語言表現、回應品質與流程配合度。最後確認供應方的整合範圍、後續維運分工,以及未來更換模型或平台時,資料與系統如何遷移。把這些條件寫成可驗證的需求,再進入方案比較,選型依據才會貼近營運,而非只追逐模型版本。
企業私有化 AI 部署如何分階段落地與驗證?
部署不必一開始就涵蓋全組織。較穩健的做法,是挑選範圍明確、資料來源可盤點、結果能由人員覆核的工作情境,例如內部文件查詢,再逐階段確認是否適合擴大。企業私有化 AI 部署可依以下五個階段推進,每一階段都應留下可檢視的成果,以及繼續、修正或暫停的依據。
- 需求盤點:由業務負責人與資訊團隊界定使用者、工作流程、預期結果及不可逾越的邊界。交付成果是明確的使用情境與初步驗收條件;若需求仍停留在「想導入 AI」,應先釐清要解決的問題。
- 資料檢視:由資料負責單位、資訊與資安人員盤點資料來源、格式、更新方式及存取限制。整理資料清單與待處理事項,確認資料是否足以支援測試,以及哪些內容需排除或限制使用。
- 概念驗證:由業務、技術及資安相關人員共同測試範圍有限的情境。記錄測試資料、常見問題與人工覆核結果,依事先約定的標準判斷是否修正、擴大或停止。
- 整合上線:由系統負責人與使用單位確認權限、既有系統串接、操作規範和異常處理流程。交付內容應包含上線檢核、責任分工及使用者指引,並先讓指定範圍內的使用者依流程操作。
- 持續維運:由平台、資料與業務負責人分別追蹤系統狀態、知識更新、使用回饋與待處理問題。建立定期檢視方式,讓後續調整有紀錄、有負責人,而不是上線後便無人接手。
POC 如何避免只證明技術能運作?
概念驗證不應只看模型能否產生回答。開始前先定義測試使用者、資料範圍、流程邊界和驗收標準,再一併檢視回答品質、任務完成度、資安條件、系統整合與維運可行性。測試結果應連同限制與人工介入情形一併記錄,才能判斷問題來自資料、流程或技術選擇,並據此決定下一步。
正式上線前要完成哪些營運準備?
上線前確認誰負責設定權限、更新知識、調整模型、監控系統及接收問題回報;也要安排使用規範、異常處理與轉交人工的流程。上線後持續觀察回答品質、任務完成情形、實際使用狀況與人工介入需求,再依使用者回饋和營運紀錄安排優化,不預設固定成效。若正規劃需求評估、概念驗證與落地分工,可了解企業 AI 顧問落地陪跑。
從部署規劃到持續維運:建立可控的企業 AI 路徑
私有化能增加企業對資料與運作環境的掌控,但不會自動降低系統複雜度。資料需要有人維護,模型需要有人檢視,設備與整合也需要持續管理。企業私有化 AI 部署要長期可控,關鍵是明確界定責任,並建立固定的檢視與問題回報機制。
部署完成後,企業需要持續管理什麼?
上線不是終點。企業應定期檢視資料來源是否仍適用、知識內容是否更新、存取權限是否符合職務,以及操作紀錄是否能支援問題追查。也要追蹤模型回應品質、錯誤回報、人工覆核情形與使用者是否採納結果。當使用情境或使用量改變,再評估算力需求、系統整合範圍與服務容量,並依組織能力安排調整週期。
如何選擇能共同落地的整合夥伴?
除了確認技術能否串接,也要確認合作是否涵蓋需求盤點、概念驗證、既有系統整合與後續優化,以及各階段如何交接。可先把責任分成幾個範圍:
- 企業內部:訂定資料分類與使用規範,管理人員權限,安排知識內容負責人,並決定回答錯誤時的覆核與處理方式。
- 整合夥伴:依約定範圍協助需求評估、概念驗證與系統串接,並與企業確認交付內容及後續協作方式。
- 平台與硬體供應方:說明平台、模型與 AI Server 的適用條件、管理方式及支援邊界;具體功能與企業環境的適配情形,應在評估時逐項確認。
Neuro PrivateHub 是為企業私有化與內部整合設計的 AI 平台,可納入企業對資料管理、模型調度與既有系統協作的整體評估。REAS 睿思智慧亦提供 AI 系統整合與顧問落地陪跑。若正在整理需求、責任分工或驗證方向,可進一步洽談企業 AI 部署評估,再依自身環境判斷合適的下一步。
從可驗證的起點,走向長期可控的 AI 應用
企業私有化 AI 部署應從明確的使用情境與資料責任開始,再逐步確認架構、整合方式及維運分工。先用範圍清楚的場景驗證,再依實際回饋調整,能讓每一步都有依據,也避免把部署簡化成單純採購模型或設備。
若需要平台與軟硬整合的評估方向,Neuro PrivateHub 專為企業私有化與內部整合設計;REAS 睿思智慧亦提供 AI Server、系統串接與顧問落地陪跑,協助企業依需求梳理導入路徑。歡迎與 REAS 睿思智慧討論企業私有化 AI 部署需求,從可檢視、可逐步擴充的計畫開始,規劃下一步。
常見問題
什麼是企業私有化 AI 部署?
企業私有化 AI 部署,是在企業可管理的環境中運行 AI,並自行規劃資料、模型與使用者存取方式。它不只是選擇系統放在哪裡,還要設定權限、操作紀錄、資料更新及維運責任。部署架構應依資料敏感度、既有環境、整合需求與內部管理能力評估,不能把部署位置直接視為治理已完成。
企業私有化 AI 部署一定要使用地端伺服器嗎?
不一定,是否採用地端伺服器,取決於資料控管要求、既有基礎設施、整合情境與維運能力。地端環境和其他受控架構各有管理方式與限制,不能只看「私有化」名稱判斷是否合適。選型前先確認資料會經過哪些系統、由誰管理,以及企業能承擔哪些維運工作,再比較不同架構。
私有化 AI 可以確保企業資料完全不外洩嗎?
不能只靠部署方式保證資料零風險。資料安全還與使用者權限、網路邊界、操作紀錄、使用者行為、供應鏈及日常維護有關。企業應按資料敏感程度設計相應控管,確認資料如何進出系統、誰能存取及如何追查異常;適用的資安與法遵要求,則應由內部資安及法遵人員確認。
企業導入私有化 AI,應該先買 AI Server 嗎?
不建議尚未盤點需求就先採購硬體。先界定使用情境、模型需求、資料來源、預估使用規模與既有環境,才能評估所需運算資源及整體架構。不同模型與工作負載對設備的要求可能不同,規格應依實際部署條件確認,不宜只憑單一品牌或規格做決定,也要一併考量後續管理與擴充方式。
企業私有化 AI 部署需要多久才能上線?
沒有適用所有專案的固定上線時程。資料準備程度、系統整合範圍、資安審查、硬體環境與驗收條件,都會影響規劃進度。較務實的做法是先界定範圍清楚的概念驗證,根據測試結果確認待補工作,再安排正式整合。啟動前應與相關負責人確認階段里程碑、交付成果及決策條件。
私有化 AI 適合中小企業嗎?
是否適合不只看企業規模,也要看資料敏感度、實際使用情境、資源配置與內部維運能力。可先選擇一項範圍有限、結果能檢視的工作流程進行驗證,再比較自行建置與整合式方案的控制方式及責任分工。評估時也要納入長期維護所需的人力安排,避免只確認初期能否啟用。
企業私有化 AI 如何串接既有系統與內部知識?
通常需先盤點資料來源、系統介面及存取政策,再依情境規劃應用程式介面串接、知識檢索、身分權限與資料更新流程。不同系統的格式和管理規則未必一致,因此不應假設所有內容都能直接匯入或共用。可先以單一流程驗證資料如何進出、使用者能看到哪些內容,以及更新後如何維護。
企業私有化 AI 上線後還需要維運嗎?
需要,因為資料會更新,使用情境也可能改變。上線後應持續檢查權限、知識內容、回答品質、系統狀態、異常回報與資源使用情形,並安排問題處理流程。企業宜指定內部負責人,並與合作夥伴釐清平台、資料、整合及維護工作的分工,再依定期檢視結果安排調整。